
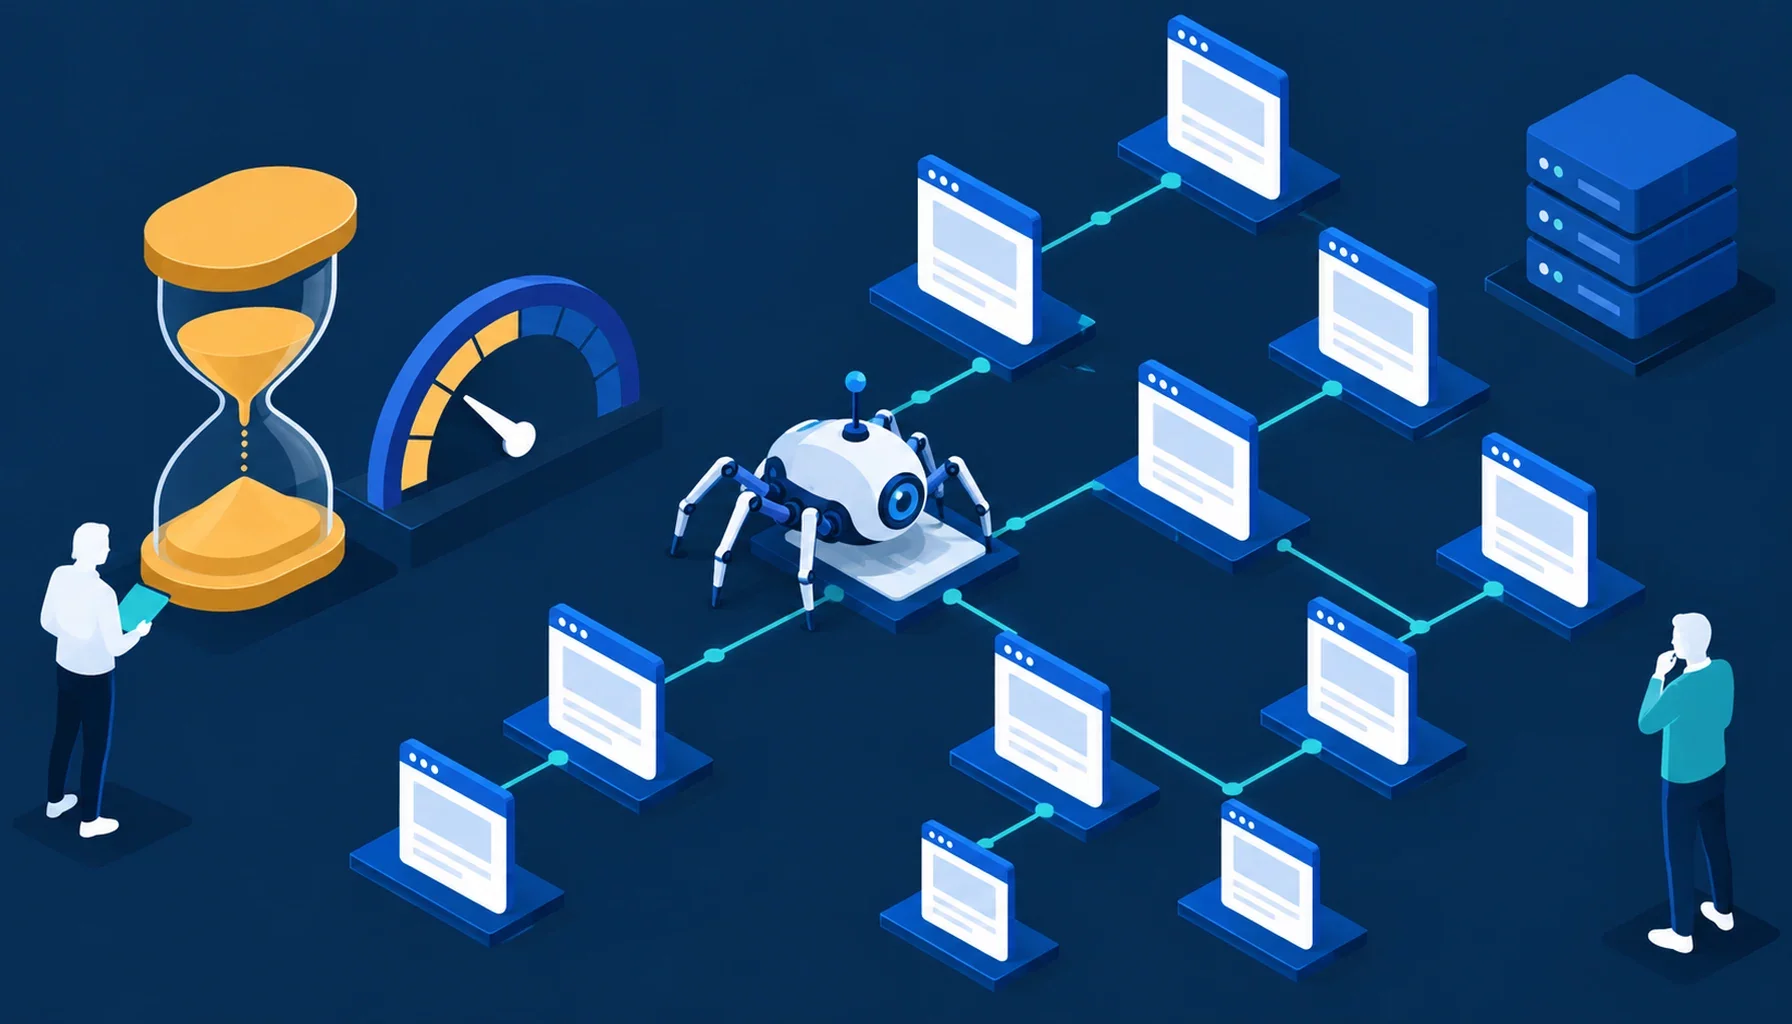
Chaque moteur de recherche alloue à votre site une quantité limitée de ressources d'exploration, une réalité que l'on désigne sous le terme de budget de crawl. Concrètement, il s'agit du nombre de pages que Googlebot accepte de parcourir sur votre domaine pendant une période donnée, en fonction de la santé technique du site et de l'intérêt qu'il lui porte. Sur un site vitrine de quelques dizaines d'URL, cette notion reste anecdotique car le robot visite tout sans difficulté, souvent en une seule session. En revanche, dès que le volume grimpe à plusieurs milliers ou dizaines de milliers de pages, la façon dont le robot dépense cette enveloppe devient un levier de performance décisif. Un budget mal réparti se traduit par des pages stratégiques explorées trop rarement, des mises à jour ignorées pendant des semaines et des contenus neufs qui tardent à apparaître dans l'index, avec un manque à gagner direct sur le trafic organique. Comprendre ce mécanisme, puis le maîtriser, permet d'orienter l'attention des robots vers ce qui compte vraiment pour votre visibilité plutôt que de la laisser se disperser sur des adresses sans valeur.
De quoi parle-t-on exactement ?
Le budget de crawl repose sur deux composantes que Google combine en permanence pour décider du rythme de ses visites. La première est la vitesse d'exploration tolérée, c'est-à-dire le rythme auquel le robot peut solliciter votre serveur sans le surcharger ni dégrader l'expérience des internautes qui naviguent au même moment. La seconde est la demande de crawl, qui dépend de la popularité de vos URL, de leur fraîcheur et du signal de qualité global que renvoie votre domaine. Lorsque nous réalisons un audit SEO à Arras pour un client e-commerce, l'une des premières observations porte justement sur l'écart entre le nombre de pages publiées et le nombre de pages réellement explorées chaque jour. Cet écart révèle immédiatement s'il existe un problème de gaspillage à corriger en priorité, et il guide toute la suite du diagnostic technique.
Il faut aussi distinguer l'exploration de l'indexation, deux étapes souvent confondues qui obéissent pourtant à des logiques différentes. Un robot peut parcourir une page sans jamais décider de la stocker dans l'index, et inversement une page peut rester indexée longtemps après avoir cessé d'être explorée régulièrement. Le budget de crawl concerne strictement la première phase, celle de la découverte et du rapatriement des contenus, avant tout jugement sur leur pertinence. Pour une boutique en ligne dont le catalogue évolue quotidiennement, une exploration lente signifie que les nouveaux produits, les changements de prix ou les ruptures de stock mettent trop de temps à être perçus par le moteur, ce qui fausse les résultats affichés aux internautes.
Prenons l'exemple concret d'un site marchand de vingt mille références qui met à jour ses stocks toutes les heures. Si Googlebot n'explore que deux mille URL par jour et que la moitié de ces visites tombe sur des pages parasites, seules quelques centaines de fiches produits utiles sont réellement rafraîchies quotidiennement. À ce rythme, il faudrait plusieurs semaines pour que l'intégralité du catalogue soit revisitée, une latence rédhibitoire pour un secteur où les prix bougent sans cesse. C'est précisément ce genre de calcul qui pousse les sites à fort volume, qu'ils soient marchands, éditoriaux ou classifieds, à surveiller cette mécanique de près plutôt que de la considérer comme un détail réservé aux ingénieurs.
Qui doit vraiment s'en préoccuper ?
Tous les sites ne sont pas concernés de la même manière, et il serait contre-productif de faire de l'optimisation du budget de crawl une obsession universelle. Un site institutionnel de cent pages, mis à jour de temps en temps, sera intégralement exploré sans que vous ayez le moindre effort à fournir, et vouloir intervenir dans ce cas relèverait de la sur-optimisation. Le sujet devient réellement sensible au-delà de quelques milliers d'URL, ou lorsque le site génère automatiquement de nombreuses pages à partir d'une base de données. Les boutiques e-commerce figurent en tête des profils exposés, notamment à cause des variantes produits, des filtres et des pages de catégories démultipliées à l'infini. Les portails d'annonces, les sites d'actualité au rythme de publication soutenu et les plateformes générant du contenu utilisateur entrent également dans cette catégorie où chaque ressource d'exploration compte.
Le second facteur déterminant est la fréquence de mise à jour attendue par les internautes et par le moteur. Un média local du Pas-de-Calais qui publie plusieurs articles par jour a besoin que ses nouvelles pages soient découvertes en quelques heures, faute de quoi il perd le bénéfice de l'actualité et cède le terrain à des concurrents plus rapidement explorés. À l'inverse, un site dont le contenu bouge peu peut tolérer une exploration plus espacée sans conséquence sur son positionnement. Il existe enfin un troisième signal d'alerte souvent négligé : la présence massive de pages de faible valeur générées par le système technique lui-même. Paramètres d'URL, sessions, pages de tri ou d'impression viennent gonfler artificiellement le périmètre à explorer et détournent le robot des contenus rentables.
Un test simple permet de savoir si vous êtes concerné avant même toute analyse approfondie. Comparez le nombre total d'URL indexables de votre site au nombre moyen de pages explorées par jour affiché dans la Search Console. Si la première valeur dépasse de plusieurs fois la seconde, cela signifie qu'une part de votre contenu attend son tour bien trop longtemps entre deux passages du robot. Dès que ces symptômes se cumulent, la question du gaspillage de crawl mérite d'être posée sérieusement et traitée avec méthode, en commençant toujours par les chantiers au meilleur rapport entre effort et impact.
Ce qui dilapide votre enveloppe d'exploration
Le premier ennemi du budget de crawl, ce sont les pages inutiles que le robot passe son temps à visiter au détriment des vraies pages stratégiques. Sur un site marchand, les URL à facettes constituent le cas d'école : chaque combinaison de filtres couleur, taille, marque ou prix crée une adresse distincte, si bien qu'une catégorie de trente produits peut engendrer plusieurs milliers d'URL techniquement explorables. À cela s'ajoutent les chaînes de redirections, les pages en erreur laissées en place, les contenus dupliqués et les paramètres de suivi qui multiplient les variantes d'une même page sans rien apporter à l'internaute. Chaque ressource dépensée sur ces adresses parasites est une ressource en moins pour vos fiches produits et vos pages de conversion. Réaliser régulièrement l'audit technique de votre site permet d'identifier précisément ces fuites avant qu'elles ne pénalisent l'exploration des contenus rentables.
Dans les journaux serveur d'un e-commerce mal maîtrisé, le constat est souvent frappant : on découvre que soixante à quatre-vingts pour cent des requêtes de Googlebot portent sur des URL à paramètres, des pages de recherche interne ou des variantes de tri qui n'ont aucune vocation à se positionner. Le robot épuise ainsi son enveloppe sur du vide pendant que les nouvelles collections attendent d'être découvertes. Ce diagnostic chiffré change généralement la perception du client, car il transforme une notion abstraite en un pourcentage de ressources gaspillées parfaitement tangible. Le tableau ci-dessous récapitule les principaux gaspilleurs rencontrés sur les sites volumineux, le symptôme observable qui les trahit et l'action corrective à engager, classés du plus fréquent au plus insidieux.
| Gaspilleur de budget de crawl | Symptôme observable | Action corrective |
|---|---|---|
| URL à facettes et filtres | Explosion du nombre d'URL crawlées dans les logs | Blocage via robots.txt ou balise noindex ciblée |
| Chaînes de redirections | Multiples sauts 301 avant la page finale | Redirection directe vers l'URL de destination |
| Pages en erreur 404 persistantes | Codes 404 récurrents dans les journaux serveur | Suppression des liens ou redirection pertinente |
| Contenus dupliqués par paramètres | Même contenu sous plusieurs adresses | Balise canonique et nettoyage des paramètres |
| Pages orphelines de faible valeur | Crawl fréquent sans trafic ni positionnement | Désindexation ou consolidation éditoriale |
Comment préserver et orienter les robots ?
Préserver son budget de crawl commence par un travail de tri rigoureux sur ce que le robot a le droit d'explorer. Le fichier robots.txt reste l'outil le plus direct pour interdire l'accès aux répertoires sans intérêt, comme les espaces de recherche interne, les paniers ou les pages de tri générées à la volée. La balise meta noindex intervient en complément pour les pages qui doivent rester accessibles aux internautes mais n'ont pas vocation à peser dans l'index. L'attribut canonique, quant à lui, consolide les signaux vers la version de référence lorsqu'un contenu existe sous plusieurs adresses. Combinés avec discernement, ces trois leviers réduisent drastiquement le volume d'URL à explorer et concentrent l'attention du robot là où elle produit de la valeur, à condition de ne pas les utiliser à contre-emploi.
Il faut d'ailleurs manier ces outils avec précaution, car une erreur de configuration peut coûter cher. Bloquer via robots.txt une page qui portait déjà une balise noindex empêche le robot de lire cette balise, si bien que la page reste parfois indexée sans jamais pouvoir en sortir. De même, appliquer une canonique vers une URL elle-même bloquée envoie un signal contradictoire que le moteur finit par ignorer. L'ordre des corrections compte donc autant que leur nature : on désindexe proprement avant de bloquer, on nettoie les redirections avant de retoucher le maillage, et l'on vérifie chaque changement dans les logs plutôt que de se fier à la seule théorie.
Orienter les robots passe ensuite par la qualité de la structure du site et par la clarté des chemins d'accès aux pages importantes. Un sitemap XML propre, limité aux URL canoniques réellement pertinentes et régulièrement mis à jour, agit comme une feuille de route qui signale au moteur les contenus à privilégier. Il ne remplace pas une bonne architecture mais il la renforce, notamment pour les pages profondes difficiles à atteindre par la seule navigation. En parallèle, un maillage interne bien pensé guide le robot depuis les pages populaires vers les contenus à faire remonter, tout en répartissant la valeur de manière cohérente. Les pages trop enfouies, accessibles seulement après de nombreux clics depuis l'accueil, sont mécaniquement explorées moins souvent et gagnent à être rapprochées de la surface par des liens contextuels pertinents.
Le serveur et la vitesse, des alliés sous-estimés
La rapidité de réponse de votre serveur influence directement le volume de pages que le robot accepte d'explorer. Lorsque les temps de réponse s'allongent, Googlebot ralentit spontanément son rythme pour ne pas dégrader les performances du site, ce qui réduit d'autant le nombre d'URL parcourues par visite. À l'inverse, un serveur véloce et stable autorise une exploration plus dense et plus fréquente. C'est pourquoi l'optimisation du temps de réponse serveur figure parmi les chantiers les plus rentables : mise en cache efficace, requêtes de base de données optimisées, hébergement dimensionné correctement et compression des ressources contribuent tous à élargir la fenêtre d'exploration. Sur les sites à très fort volume, chaque milliseconde gagnée sur la réponse moyenne se traduit par des milliers de pages supplémentaires explorées sur un mois.
La cohérence des codes de réponse joue également un rôle que l'on oublie facilement. Un site qui renvoie de nombreuses erreurs 5xx, même passagères, envoie au moteur un signal de fragilité qui l'incite à espacer ses visites par prudence, parfois durablement après un pic de surcharge. De la même manière, des redirections en cascade forcent le robot à multiplier les requêtes pour atteindre une seule page, gaspillant une ressource précieuse à chaque saut supplémentaire. Nettoyer ces chaînes pour qu'une ancienne URL pointe directement vers sa destination finale allège considérablement la charge d'exploration. Lorsqu'une agence d'Arras accompagne un site marchand régional, ce travail sur la fiabilité serveur et la propreté des codes de réponse produit souvent des résultats visibles en quelques semaines, avant même toute intervention sur le contenu.
Un cas fréquemment observé concerne les migrations de site menées sans nettoyage des anciennes URL. Chaque adresse historique redirige vers une nouvelle, qui redirige parfois elle-même vers une troisième après une refonte ultérieure, si bien que le robot enchaîne trois ou quatre sauts avant d'obtenir un contenu. Multiplié par des milliers d'URL, ce surcoût d'exploration ampute le budget disponible pour les pages actives et retarde la découverte des nouveautés. Aplatir ces chaînes reste l'une des corrections les plus simples à mettre en oeuvre pour un gain immédiat, ce qui en fait presque toujours une priorité dans le plan d'action.
Mesurer et suivre le crawl dans la Search Console
La Search Console apporte un éclairage précieux à travers son rapport dédié aux statistiques d'exploration, accessible dans les paramètres du site. On y suit l'évolution du nombre de requêtes de crawl, le temps de téléchargement moyen et la répartition des réponses par code, autant d'indicateurs qui permettent de vérifier concrètement l'effet des actions menées. Une baisse du temps de téléchargement moyen après une optimisation serveur, ou une diminution de la part de codes 404, valide les corrections apportées. Le rapport distingue également les objectifs de crawl, ce qui aide à repérer si le robot passe trop de temps sur des ressources annexes comme des fichiers CSS ou des images plutôt que sur les pages HTML utiles. Suivre ces courbes dans la durée transforme une intuition en pilotage mesuré.
Pour aller plus loin, l'analyse des journaux serveur reste la source la plus fiable pour comprendre le comportement réel des robots. Contrairement aux estimations agrégées de la Search Console, les logs enregistrent chaque passage effectif de Googlebot : quelles URL il visite, à quelle fréquence, avec quel code de réponse et depuis quel type d'agent, mobile ou ordinateur. Cette matière brute révèle des vérités que les outils de crawl simulé ne montrent pas, comme ces milliers de pages parasites explorées quotidiennement au détriment des catégories stratégiques. Croiser ces données avec la liste des pages qui génèrent réellement du trafic met en évidence les déséquilibres et hiérarchise les corrections avec précision.
L'objectif n'est jamais de maximiser à tout prix le nombre de pages explorées, mais d'améliorer la qualité de la répartition entre pages utiles et pages superflues. Une bonne optimisation se reconnaît à ceci : les URL stratégiques sont explorées plus souvent, les nouveautés sont découvertes plus vite et les ressources cessent de se disperser sur des adresses sans valeur. Ce pilotage régulier, mené sur la durée et documenté à chaque étape, transforme le budget de crawl d'une contrainte subie en un véritable atout de référencement pour les sites ambitieux du Pas-de-Calais comme d'ailleurs.
Articles similaires
Redirections 301 → sans perdre de trafic
Gérer ses redirections 301 sans perdre de trafic : distinguer 301 et 302, transmettre le jus SEO, bâtir un plan de migra…
JavaScript et SEO → les pièges à éviter
JavaScript et SEO : comprendre le rendu par Google, choisir entre CSR, SSR et SSG, éviter les contenus non indexés et le…
Sitemap XML → le construire et le soumettre
Construire et soumettre un sitemap XML : savoir ce qu'il doit contenir, choisir le bon format, le déclarer dans robots.t…