
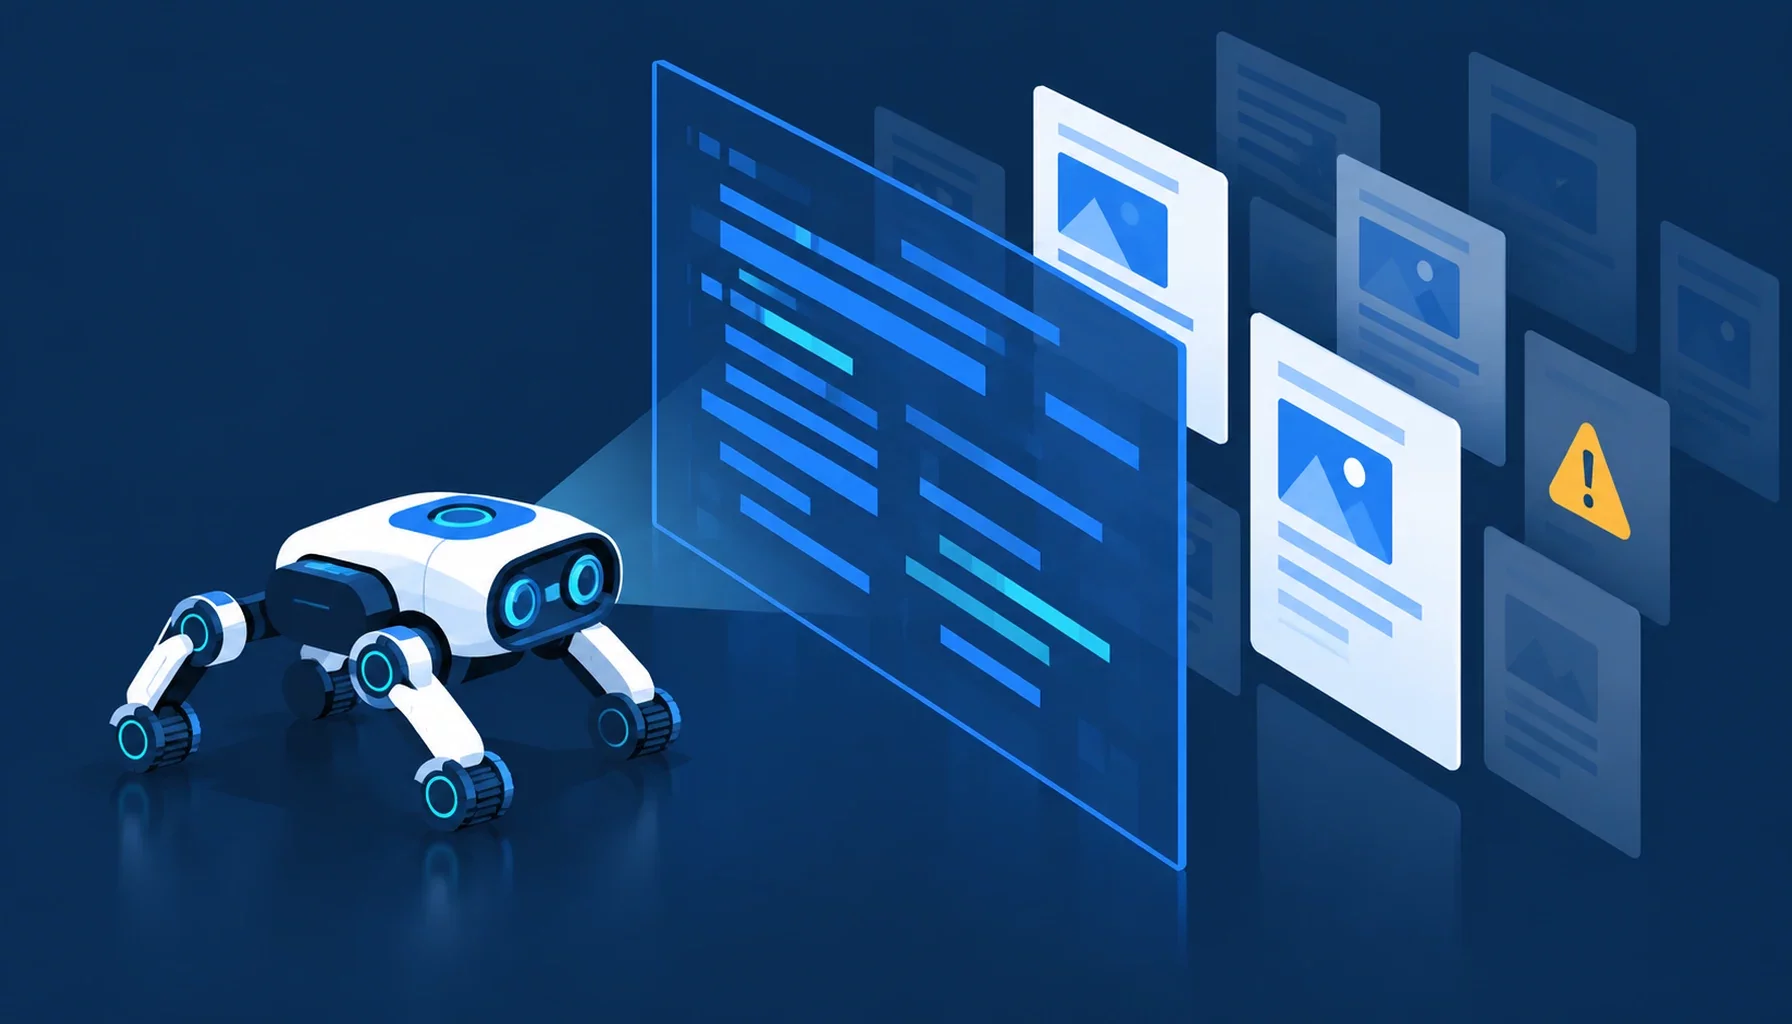
Les sites modernes reposent massivement sur le JavaScript pour afficher menus, fiches produits, filtres et contenus dynamiques. Cette richesse d'interface a un revers rarement anticipé : ce que voit un internaute dans son navigateur n'est pas toujours ce que voit le robot d'exploration de Google. Comprendre la relation entre JavaScript et le SEO devient donc une compétence décisive pour quiconque veut être correctement indexé et bien positionné. Un moteur doit récupérer le code, l'interpréter, exécuter les scripts, puis seulement lire le contenu final, et chaque étape peut échouer silencieusement. Résultat : des pages entières deviennent invisibles alors que le site paraît parfaitement fonctionnel à l'écran. Dans notre travail d'accompagnement de sites d'entreprises à Arras, ce décalage entre le rendu humain et le rendu machine explique une part importante des problèmes de visibilité que nous corrigeons chaque année.
Comment Google explore et rend le JavaScript
Le traitement d'une page par Google se déroule en deux temps bien distincts, et cette temporalité est la source de la plupart des malentendus. Le robot commence par télécharger le fichier HTML brut renvoyé par le serveur, il en extrait les liens et les ressources, puis il place la page dans une file d'attente en vue du rendu. Ce n'est que dans un second temps, parfois plusieurs jours plus tard, qu'un navigateur sans interface exécute enfin le JavaScript pour produire le contenu final. Si l'essentiel de votre texte n'apparaît qu'après cette exécution, il reste donc invisible tant que la seconde vague de traitement n'a pas eu lieu. Lorsque nous démarrons un audit SEO à Arras, cette distinction entre exploration et rendu est systématiquement le premier point que nous vérifions, car elle conditionne toute la stratégie technique.
La double vague d'indexation expliquée simplement
Concrètement, Google fonctionne comme s'il lisait deux fois votre page avec des yeux différents. La première lecture porte sur le HTML initial, celui que le serveur envoie avant toute exécution de script : c'est rapide, peu coûteux et immédiatement exploitable. La seconde lecture intervient après le rendu, quand le moteur dispose de ressources suffisantes pour lancer son navigateur virtuel et laisser tourner vos scripts. Ce mécanisme en double vague d'indexation a une conséquence directe : les métadonnées, les balises de titre et les liens présents dès le HTML sont pris en compte bien plus vite et bien plus sûrement que ceux injectés ultérieurement. Un site qui dépend entièrement de la seconde vague accumule des retards d'indexation, subit des mises à jour tardives et voit ses contenus fraîchement publiés ignorés pendant des jours. La priorité consiste donc à charger le maximum d'informations critiques dès la première réponse serveur.
Le budget de rendu, une ressource limitée
Exécuter du JavaScript coûte cher, bien plus cher que lire du HTML statique, et Google alloue à cette tâche des ressources qui ne sont pas illimitées. On parle souvent de budget de crawl pour l'exploration, mais il existe aussi un budget de rendu qui détermine combien de pages le moteur acceptera de traiter par sa lourde phase d'exécution. Plus votre site est volumineux, plus vos scripts sont lents, et plus ce budget se dilue au détriment de l'indexation globale. Des temps de rendu élevés, des ressources bloquées ou des scripts qui échouent poussent le robot à espacer ses visites et à négliger les pages profondes. Pour un site marchand de plusieurs milliers de références, cette contrainte devient critique : les fiches les moins accessibles finissent hors index. Alléger le poids des scripts, différer le superflu et servir un contenu déjà constitué sont autant de leviers pour préserver cette ressource rare.
Ce que le robot voit vraiment de votre page
La meilleure façon de mesurer l'écart entre perception humaine et perception machine consiste à comparer le code source initial et le rendu final. Le code source, c'est la réponse brute du serveur, celle que vous obtenez avant toute exécution de script. Le rendu, c'est l'arbre du document tel qu'il existe une fois le JavaScript exécuté, avec tous ses ajouts et ses modifications. Quand un texte apparaît uniquement dans le second et jamais dans le premier, vous tenez la preuve d'une dépendance risquée. Beaucoup d'équipes découvrent avec stupeur que leur contenu principal, leurs avis clients ou leur maillage interne n'existent pas dans la source brute et reposent intégralement sur des appels asynchrones. Ce contrôle simple, réalisé page type par page type, révèle immédiatement les zones fragiles et oriente les corrections vers ce qui compte réellement pour l'indexation.
Modes de rendu : du client au serveur
Le choix du mode de rendu est la décision d'architecture qui pèse le plus lourd sur la visibilité d'un site riche en JavaScript. Chaque approche répartit différemment le travail entre le serveur et le navigateur, et cette répartition détermine ce que Google reçoit au premier chargement. Comprendre ces familles techniques permet de dialoguer utilement avec les développeurs et d'éviter des impasses coûteuses à corriger après coup.
Rendu côté client, la source du problème
Le rendu côté client, souvent désigné par le sigle CSR, consiste à envoyer au navigateur une page presque vide accompagnée d'un gros paquet de JavaScript chargé de tout construire. Le serveur ne renvoie qu'une coquille minimale, parfois réduite à une simple balise conteneur, et c'est le script qui va chercher les données puis fabriquer l'affichage. Pour un moteur de recherche, cette approche est la plus périlleuse : la première vague ne trouve qu'une page vide de sens, et tout dépend de la seconde vague de rendu. Si l'exécution échoue, traîne ou se heurte à une ressource bloquée, le contenu n'existe tout simplement pas aux yeux de Google. C'est le scénario que nous rencontrons le plus fréquemment lors de l'audit technique de sites conçus autour d'une application monopage, où l'ergonomie a été privilégiée sans mesurer l'impact sur l'indexation.
Rendu serveur, génération statique et hydratation
Face aux limites du tout-client, plusieurs approches renvoient au navigateur une page déjà remplie. Le rendu côté serveur, ou SSR, génère le HTML complet à chaque requête sur le serveur, si bien que le robot reçoit immédiatement un contenu lisible sans attendre l'exécution des scripts. La génération statique, ou SSG, va plus loin en produisant les pages à l'avance, lors d'une phase de construction, ce qui offre une rapidité maximale et une grande fiabilité pour l'indexation. Dans les deux cas intervient ensuite une phase d'hydratation : le JavaScript se rattache au HTML déjà présent pour rendre la page interactive, sans reconstruire le contenu. Cette combinaison réunit le meilleur des deux mondes, un contenu visible tout de suite pour les moteurs et une interactivité complète pour l'internaute. La plupart des projets ambitieux sur lesquels nous intervenons dans le Pas-de-Calais migrent progressivement vers ces architectures pour sécuriser leur référencement.
Tableau comparatif des modes de rendu
Pour choisir sereinement, il faut mettre en regard chaque mode de rendu avec ce que Google en perçoit et la recommandation qui en découle. Le tableau ci-dessous synthétise cette lecture technique et sert de grille de décision lors de nos échanges avec les équipes de développement. Il aide à trancher entre confort de développement, performance et sécurité pour l'indexation, trois exigences qu'il faut concilier plutôt qu'opposer.
| Mode de rendu | Visibilité pour Google | Recommandation |
|---|---|---|
| Rendu côté client (CSR) | Faible : page initiale vide, dépendante de la seconde vague | À éviter pour les contenus stratégiques |
| Rendu côté serveur (SSR) | Élevée : HTML complet dès la première réponse | Recommandé pour les sites dynamiques |
| Génération statique (SSG) | Très élevée : pages prégénérées et immédiatement lisibles | Idéal pour contenus stables et éditoriaux |
| Prerendering ciblé | Bonne : version rendue servie aux robots | Solution de rattrapage sur base existante |
Les pièges concrets qui bloquent l'indexation
Au-delà des choix d'architecture, la vie quotidienne d'un site accumule des erreurs de mise en œuvre qui sabotent silencieusement le référencement. Ces pièges sont souvent invisibles à l'écran, ce qui les rend d'autant plus dangereux, car rien n'alerte l'équipe tant que le trafic ne s'effondre pas. Les repérer suppose de raisonner comme un robot plutôt que comme un utilisateur.
Contenus injectés et non détectés
Le premier piège concerne les contenus chargés après coup, au clic ou au défilement, via des appels asynchrones. Un texte descriptif qui n'apparaît qu'après avoir déplié un onglet, des avis affichés seulement au scroll ou des fiches remplies par une requête tardive risquent fort de ne jamais être indexés. Google n'interagit pas avec la page comme un internaute : il ne clique pas, ne fait pas défiler et n'attend pas indéfiniment qu'une requête réponde. Si l'information dépend d'un événement utilisateur pour exister dans le document, elle reste hors de portée du moteur. Ce mécanisme explique pourquoi certaines pages riches en contenu paraissent maigres aux yeux de Google, avec pour conséquence directe une partie des les erreurs d'indexation que nous diagnostiquons. La règle est claire : tout contenu important doit être présent dans le document sans exiger d'action de la part du visiteur.
Liens en JavaScript et navigation cassée
Le second piège touche au maillage interne, colonne vertébrale de l'exploration. Google découvre et suit les liens uniquement lorsqu'ils sont exprimés par une balise d'ancrage classique dotée d'un attribut de destination valide. Or de nombreux sites déclenchent la navigation par des gestionnaires d'événements posés sur des éléments génériques, sans véritable adresse cible dans le code. Pour l'internaute, le clic fonctionne parfaitement ; pour le robot, il n'existe aucun chemin à suivre, et des pans entiers du site deviennent inaccessibles. Les fenêtres de navigation qui modifient l'affichage sans changer l'adresse réelle aggravent encore le problème, car elles empêchent le moteur d'associer un contenu à une adresse indexable. Un maillage interne robuste repose donc toujours sur de vrais liens, avec des adresses explicites que le robot peut lire dès le HTML, indépendamment de tout script d'interaction.
Ressources bloquées et échecs silencieux
Le troisième piège est plus insidieux : il suffit d'empêcher Google d'accéder aux fichiers nécessaires au rendu pour saboter toute la page. Si les scripts ou les feuilles de style indispensables à l'affichage sont interdits d'accès par le fichier d'exclusion des robots, le moteur ne peut pas reconstruire le contenu et se contente d'une version dégradée. De la même façon, un script qui provoque une erreur d'exécution interrompt la construction de la page et laisse le robot devant un document incomplet. Ces défaillances ne génèrent aucun message visible pour l'internaute, dont le navigateur, plus tolérant, parvient souvent à s'en accommoder. Le robot, lui, abandonne. Vérifier que toutes les ressources critiques sont accessibles et surveiller les erreurs de console sur les principaux gabarits fait donc partie des contrôles indispensables avant toute mise en ligne d'un projet dépendant du JavaScript.
Frameworks, prerendering et diagnostic
Les cadres de développement populaires ne sont ni bons ni mauvais pour le référencement en eux-mêmes : tout dépend de la façon dont ils sont configurés et déployés. Bien maîtrisés, ils offrent des solutions élégantes pour concilier expérience utilisateur et visibilité. Mal exploités, ils reproduisent tous les pièges décrits plus haut. Le diagnostic régulier reste la meilleure assurance contre les dérives.
React, Vue et Angular face aux moteurs
React, Vue et Angular partagent une même logique : ils construisent l'interface dans le navigateur à partir de données, ce qui, en configuration par défaut, produit un rendu côté client peu favorable à l'indexation. Heureusement, chacun dispose de son écosystème pour basculer vers un rendu serveur ou une génération statique, à condition de faire ce choix dès la conception plutôt que de le rattraper en fin de projet. La question n'est donc pas de savoir quel cadre est le meilleur pour le SEO, mais de vérifier que la stratégie de rendu retenue expose un HTML complet aux moteurs. Un rendu universel bien configuré permet d'utiliser ces technologies modernes sans sacrifier la visibilité. À l'inverse, une application livrée en tout-client, aussi soignée soit-elle côté interface, expose son propriétaire à des mois de contre-performance jusqu'à ce que le problème soit identifié et corrigé.
Le prerendering comme solution de rattrapage
Lorsqu'un site existant ne peut pas être refondu immédiatement, le prerendering offre une voie intermédiaire précieuse. Le principe consiste à générer à l'avance une version entièrement rendue de chaque page et à la servir aux robots des moteurs, tout en laissant les internautes profiter de l'application dynamique habituelle. Cette approche restaure une visibilité correcte sans imposer une réécriture complète de l'architecture, ce qui en fait une solution transitoire souvent salutaire. Elle demande toutefois une mise en œuvre rigoureuse, car servir un contenu différent aux robots et aux humains peut, mal exécuté, être perçu comme une pratique trompeuse. La version rendue doit refléter fidèlement ce que voit l'internaute, sans divergence de contenu. Bien encadré, le prerendering permet de gagner du temps et de stabiliser le référencement pendant qu'une migration plus profonde vers un rendu serveur se prépare dans de bonnes conditions.
Diagnostiquer et corriger méthodiquement
Le diagnostic d'un site en JavaScript suit une méthode reproductible qui écarte les suppositions au profit des faits. On compare d'abord la source brute et le rendu final pour repérer les contenus manquants, puis on inspecte l'outil de test des moteurs afin de voir la page telle que le robot la construit réellement. On vérifie ensuite l'accessibilité des ressources, la validité des liens et l'absence d'erreurs d'exécution sur chaque gabarit stratégique. Le suivi de l'indexation dans la console de recherche complète l'analyse en révélant les pages exclues et les motifs invoqués. Cette démarche factuelle, appliquée régulièrement, transforme un site fragile en une base saine où chaque contenu important est garanti visible dès la première réponse serveur. C'est précisément ce travail méthodique que nous menons pour les entreprises du Pas-de-Calais soucieuses de bâtir une présence durable, où la technique sert la performance plutôt que de la freiner.
Articles similaires
Redirections 301 → sans perdre de trafic
Gérer ses redirections 301 sans perdre de trafic : distinguer 301 et 302, transmettre le jus SEO, bâtir un plan de migra…
Sitemap XML → le construire et le soumettre
Construire et soumettre un sitemap XML : savoir ce qu'il doit contenir, choisir le bon format, le déclarer dans robots.t…
HTTPS et sécurité → quel impact SEO
HTTPS et SEO : comprendre le rôle du certificat SSL, migrer de HTTP vers HTTPS sans perdre de trafic, éviter les contenu…